
Меняется доказательная база для закупок
Перестаньте покупать пиковый балл. Покупайте кривую производительности.
MLCommons сообщает, что MLPerf Endpoints заменит MLPerf Inference для дата-центров. Практический смысл — в сравнении развернутого endpoint по нагрузке и задержке в тех режимах, в которых он действительно будет работать.
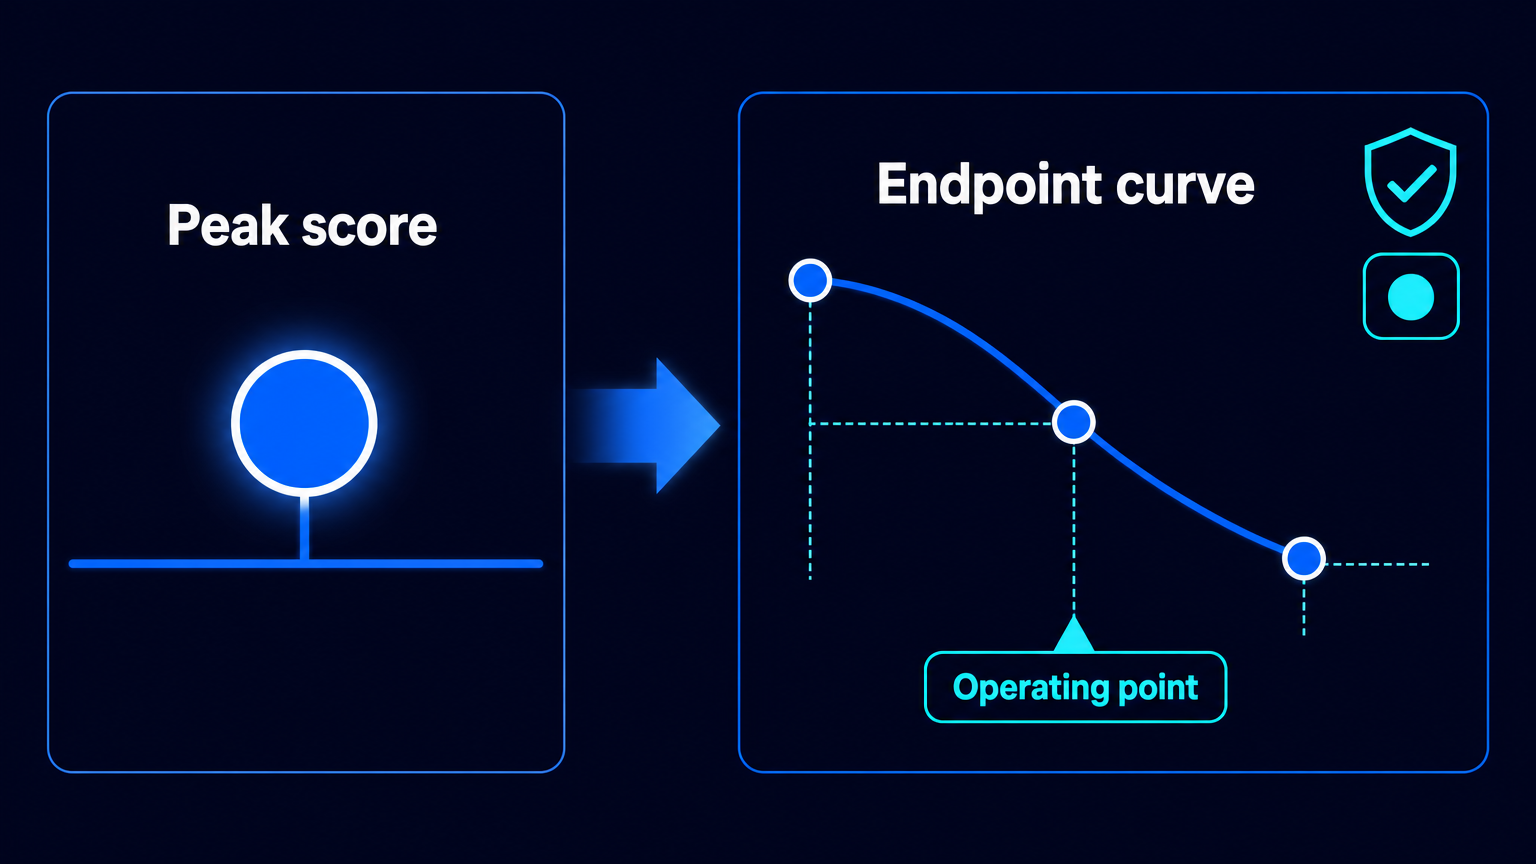
Привычная таблица результатов для ИИ-инфраструктуры начинается с эффектного числа: максимальной пропускной способности, лучшей задержки или самого быстрого результата на выбранной задаче. Это полезное, но недостаточное доказательство для покупателя. Производственные системы приобретают не для работы в предпочитаемом поставщиком режиме. Их приобретают, чтобы обслуживать определённое число одновременных пользователей и удерживать интерактивные задержки в приемлемых границах.
MLCommons переводит семейство дата-центровых бенчмарков к более операционной единице сравнения. В результатах, опубликованных 16 сентября 2026 года, организация сообщила, что MLPerf Endpoints заменит MLPerf Inference для бенчмаркинга в дата-центрах. Более половины участников MLPerf Inference v6.1 уже использовали API-ориентированный клиент-серверный тестовый контур, лежащий в основе Endpoints.
Главная новость — не самый быстрый ускоритель этого раунда. Она в изменении того, как может выглядеть убедимое сравнение: работающий ИИ-endpoint, измеренный в диапазоне одновременной нагрузки, вместо одного балла, оторванного от режима работы, который нужен заказчику.
Endpoint становится единицей сравнения для закупки
Endpoint — это развернутая комбинация модели, ПО для обслуживания запросов и аппаратной платформы. Именно эту комбинацию видят пользователи и должна эксплуатировать инфраструктурная команда. Одно название модели не определяет её поведение в продакшене; как и одно название ускорителя. На результат влияют пакетная обработка, планирование запросов, конфигурация сервинга и остальная система.
MLPerf Endpoints измеряет работающий endpoint для обслуживания модели при разной конкурентной нагрузке. Он показывает связь между пропускной способностью системы, интерактивностью для отдельного пользователя и P95-временем до первого токена. Получается кривая производительности, а не пьедестал с одним победителем.
Это существенное различие. Совокупная пропускная способность отвечает на вопрос, сколько работы система способна обработать. Интерактивность для пользователя показывает его опыт при росте нагрузки. P95-время до первого токена отражает опыт ближе к медленному краю распределения, а не только среднее значение. Конфигурация может отлично выглядеть по одному показателю и не выдерживать именно тот режим, который важен покупателю.
Полезный вопрос теперь не «Какая система самая быстрая?», а «Какой представленный endpoint выполняет наши требования к нагрузке и отзывчивости — и какими данными это подтверждено?»
Кривая не отменяет профессионального суждения. Она делает его явным. Сервис для небольшой группы аналитиков может обменять часть совокупной пропускной способности на более высокую отзывчивость. Для массового потока задач может быть выбран другой режим, если требования к взаимодействию всё ещё соблюдаются. Это операционные решения. Один пиковый балл не может принять их за покупателя.
Что изменилось — и что не изменилось
MLCommons опубликовала MLPerf Inference v6.1 с заявками от рекордных 30 организаций: облачных провайдеров, производителей чипов, поставщиков инфраструктуры и системных интеграторов. Масштаб участия важен: сравнение полезнее, когда заказчик может сопоставить разные классы поставщиков в общей методологии.
API-ориентированный клиент-серверный контур использовали более 50% участников. MLCommons также ясно обозначила направление: Endpoints заменит Inference в дата-центровом семействе бенчмарков. Это свидетельство внедрения и объявленного перехода, но не подтверждение того, что замена уже завершена. Опубликованный раунд результатов по-прежнему называется MLPerf Inference v6.1.
В релиз также вошли сквозной тест RAG, охватывающий загрузку корпуса и многошаговые ответы на вопросы, а также edge-agentic-нагрузка с требованиями к задержке и точности. Эти дополнения служат косвенным подтверждением того, что тестовые нагрузки становятся ближе к развернутым системам. Но из этого не следует, что бенчмарк измеряет бизнес-ценность, фактическую надёжность в каждом приложении или завершённые бизнес-результаты.
Кривая производительности не решает и коммерческих вопросов. MLCommons указывает, что заявки проходят экспертную проверку, требуют артефактов воспроизводимости и получают метки доступности, отличающие доступные сейчас системы от предварительных. Это ценные данные для закупки. Но они не означают, что каждую конфигурацию можно заказать сегодня, и не доказывают преимущество по цене и производительности без данных о ценах и сравнения в одном рабочем режиме.
У заявленного в релизе 5,7-кратного годового улучшения есть не менее важное ограничение: оно относится только к лучшему серверному результату DeepSeek R1 в расчёте на один ускоритель. Это не показатель общего прогресса инференса, производительности системы в целом или экономики для заказчика.
Сделайте кривую требованием в RFP
Закупочным командам стоит ответить на это изменением запрашиваемых доказательств, а не воспринять новый график как ещё один маркетинговый материал. В RFP на инференсные мощности можно требовать верифицированную кривую endpoint для приобретаемых модели, конфигурации сервинга и окна доступности. Можно задать существенный диапазон конкурентной нагрузки и условия сервиса для оценки — например, требуемую интерактивность и порог P95-времени до первого токена.
Следует также потребовать от поставщика указать, доступна ли заявленная система сейчас или находится в предварительном статусе, и предоставить связанные с результатом артефакты воспроизводимости и проверки. Это разделяет два вопроса, которые часто смешивают: хорошо ли конфигурация выступила в бенчмарке и является ли она именно той конфигурацией, которую заказчик может получить и эксплуатировать.
- Указывайте конкретный endpoint обслуживания модели для оценки, а не запрашивайте изолированный результат ускорителя.
- Определяйте диапазон одновременной нагрузки, соответствующий ожидаемому сервису, включая планируемый рост, если он существенен.
- Формулируйте требования к отзывчивости в операционных терминах: P95-время до первого токена и необходимый уровень интерактивности для пользователя.
- Запрашивайте полную верифицированную кривую в этих условиях, а не только точку пиковой пропускной способности.
- Требуйте метку доступности результата и связанные с ним материалы экспертной проверки и воспроизводимости.
- Сопоставляйте коммерческие предложения только после выравнивания конфигураций по одному рабочему режиму.
Такой подход даёт техническим командам более чистую основу для планирования мощностей, а коммерческим — более надёжную основу для сравнения предложений. Он также раньше делает компромиссы видимыми. Если поставщик способен выполнить требование по отзывчивости только при меньшей, чем ожидается, конкурентной нагрузке, это не примечание к бенчмарку. Это вопрос архитектуры и бюджета.
Лучший бенчмарк задаёт более трудный вопрос
Отдельные результаты бенчмарков останутся полезными. Они могут показать развитие возможностей и задать точки отсчёта. Но дата-центровый ИИ всё чаще поставляется как живой сервис, а такие сервисы работают при меняющемся одновременном спросе. Поэтому бенчмарк должен показывать форму производительности при этой нагрузке.
В этом значение объявленного MLCommons перехода к Endpoints. Он переносит центр сравнения от компонента или специально выбранного сценария к развернутой системе обслуживания запросов. У покупателей появляется возможность требовать данные для своего рабочего режима, а не принимать режим сравнения, удобный поставщику.
Дисциплина проста: не покупайте впечатляющий пик, достраивая всё остальное в предположениях. Определите условия сервиса, получите верифицированную кривую endpoint, проверьте доступность, а затем сравнивайте коммерческие предложения. Кривая не выберет систему за вас. Но она сделает реальный выбор видимым.

