
Практика инфраструктуры
Тест Google: мощности инференса можно объединять между регионами
Новые результаты Google Cloud для GKE показывают: в одном конкретном тесте инференс в трёх регионах почти достиг пропускной способности локального вызова. Для предприятий главный вопрос — можно ли считать разрозненные региональные квоты единым парком обслуживания.
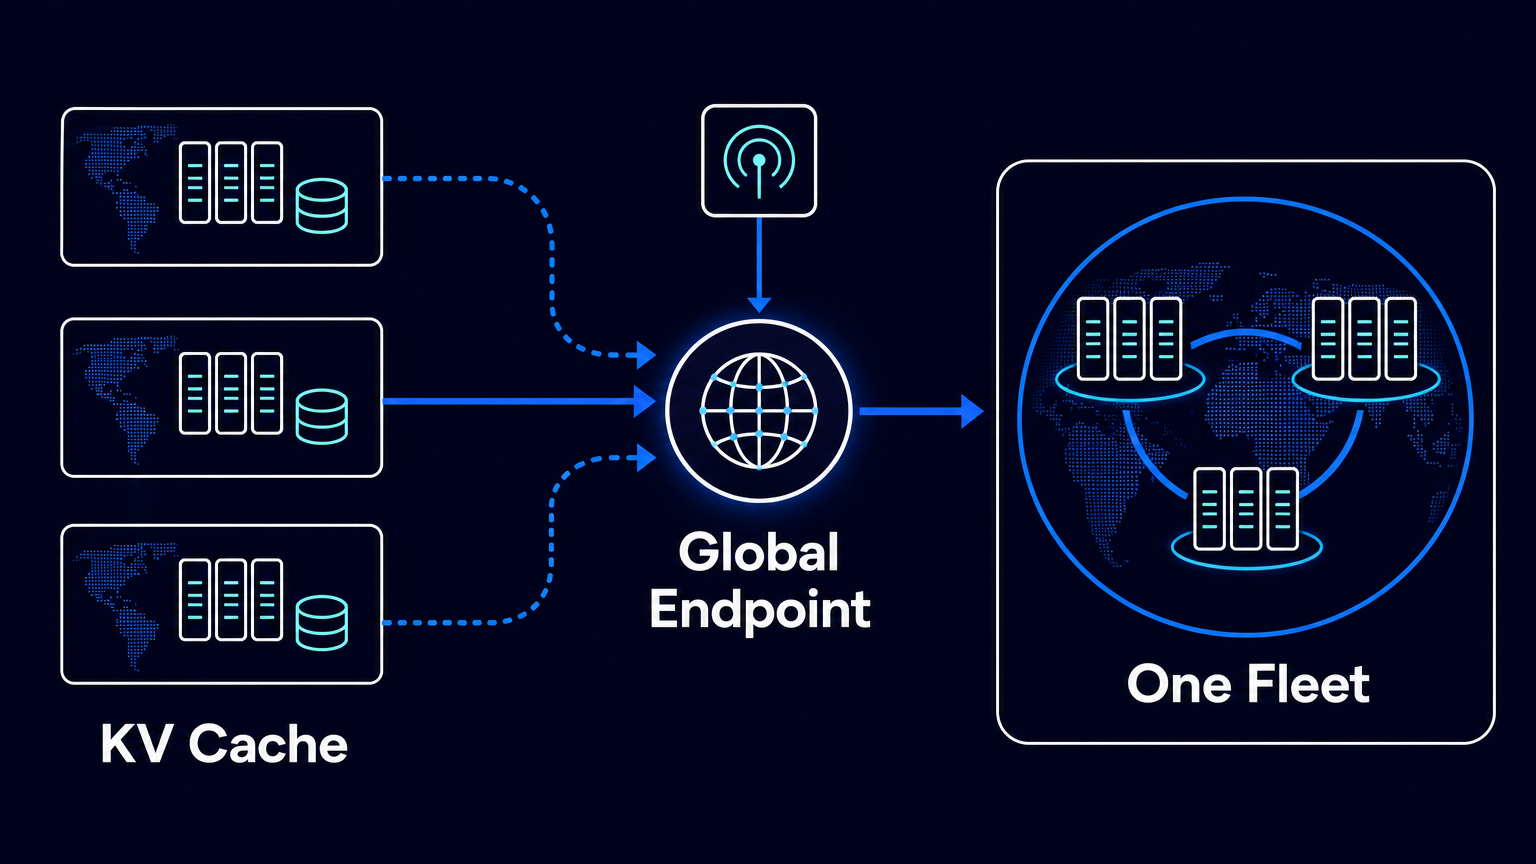
Крупная квота на ИИ-ускорители больше не обязательно должна появиться в одном регионе, чтобы стать полезной. Последние результаты Google Cloud по GKE Inference Gateway дают этому практическое подтверждение: в тесте с тремя регионами распределённый контур обслуживания достиг 8 457 токенов в секунду, а накладные расходы маршрутизации, по оценке Google, составили менее 1% относительно прямого вызова локального кластера.
Это не универсальный результат производительности. Речь идёт о заявленном тесте с одной нераскрытой моделью mixture-of-experts, обслуживаемой через SGLang, на собственной инфраструктуре Google Cloud. Но он меняет важную предпосылку планирования. Команды, которым доступны разрозненные ускорители в разных регионах, могут рассматривать их как единый будущий парк обслуживания, а не считать каждую региональную квоту ниже целевого размера непригодной для эксплуатации.
Что изменилось: появились измерения, а не новый статус продукта
21 сентября Google опубликовала результаты мульти-регионального развёртывания GKE, охватывающего 17 000 вычислительных узлов в США и Европе. В раскрытом эксперименте по пропускной способности три кластера GKE в us-east5, us-west8 и europe-west4 были размещены за одним глобальным виртуальным IP-адресом. По словам Google, система обслуживала нераскрытую модель mixture-of-experts через SGLang.
Сам шлюз не является новинкой. Google анонсировала multi-cluster GKE Inference Gateway в preview 17 марта. Сентябрьская публикация также не сообщает о новом статусе общей доступности. Существенное обновление — измеренные данные о поведении архитектуры при распределении трафика между тремя регионами.
Google сообщила о 2 898 токенах в секунду с одним кластером, 6 380 — с двумя и 8 457 — с тремя. Заявленные показатели успешности составили соответственно 99,87%, 99,95% и 99,90%. Компания также указала, что трафик через gateway достиг 99,5% пропускной способности прямого вызова локального кластера; на этом основании она оценивает накладные расходы маршрутизации в тесте менее чем в 1%.
Единицей планирования становится не обязательно крупнейшая квота в одном регионе. Ею может быть весь доступный парк — если маршрутизация понимает состояние модельных серверов.
Ключевой механизм — маршрутизация с учётом состояния модели
Обычный балансировщик может раздавать запросы по простой схеме, например round robin. Для инференса этого недостаточно, когда внешне одинаковые конечные точки несут радикально разный объём активного состояния модели. Продолжать запрос может быть дёшево в регионе, где уже находится релевантное состояние, и дорого в другом; сервер может отвечать на проверки доступности, но приближаться к состоянию, в котором полезная работа ухудшается.
Маршрутизирующий слой Google получал от модельных серверов телеметрию текущего использования KV-cache. В описанной конфигурации трафик начинал перетекать в другой регион, когда основной регион пересекал настроенный порог в 40% использования KV-cache. Именно это архитектурно важно. Gateway не просто выбирает географическую точку назначения. Он принимает решение о трафике на основе сигнала, связанного с рабочим состоянием системы обслуживания моделей.
Документация Google описывает более общий паттерн: единая приватная конечная точка объединяет мощности ускорителей между регионами и направляет избыточный трафик, когда предпочтительный регион достигает предела мощности. Сентябрьский тест показывает этот паттерн в конкретном масштабном примере. Он не доказывает, что задержка, стоимость или надёжность будут одинаковыми для любой географии и нагрузки.
Что должны решить корпоративные инфраструктурные команды
Немедленный вопрос не в том, нужно ли переводить в мульти-региональный режим все инференсные нагрузки. Он в том, остаётся ли большая квота в одном регионе обязательным условием запуска production-сервиса. Для команд с дефицитом мощностей ответ всё чаще может быть отрицательным — но только после испытания реальной нагрузки в предполагаемой региональной топологии.
- Рассматривайте поиск мощностей как проектирование парка. Соберите данные о пригодных квотах по регионам, затем проверьте, достигает ли их совокупность целевого уровня сервиса. Не отбрасывайте небольшие квоты автоматически лишь потому, что каждая из них по отдельности недостаточна.
- Сделайте телеметрию обслуживания частью проектирования маршрутизации. В тесте Google раскрыт сигнал давления на KV-cache; для других серверов моделей и нагрузок могут понадобиться другие сигналы. Принцип один: направлять трафик по условиям, влияющим на полезный инференс, а не только по доступности конечной точки.
- Осознанно задайте политику предпочтительного региона и перелива трафика. Глобальный адрес не отменяет требований к размещению данных, целей по задержке и границ отказа между регионами. Эти ограничения должны определить допустимые регионы до того, как давление на мощности определит направление трафика.
- Проведите сравнение на собственной нагрузке. Измерьте пропускную способность, успешность обработки и значимый для пользователя профиль задержек для прямого локального обслуживания и для предполагаемого мульти-регионального пути. Показатель Google «менее 1%» относится к её тесту, а не автоматически к иной модели, фреймворку, сетевому пути или развёртыванию.
Чего результаты не показывают
К цифрам следует относиться строго. Google не раскрывает распределение узлов, стоящее за таблицей производительности трёх кластеров, количество и модели ускорителей, а также идентичность и конфигурацию модели mixture-of-experts. Описание развёртывания на 17 000 узлов не означает, что все эти узлы одновременно участвовали в таблице. Тест не был мультиоблачным: все раскрытые кластеры работали на GKE в регионах Google Cloud.
Показатели успешности также не являются SLA по доступности, а тест не демонстрирует ни экономию в деньгах, ни общий ориентир по утилизации. Рост пропускной способности — весомое операционное свидетельство для этой архитектуры в этих условиях. Это не обещание линейного масштабирования, накладных расходов ниже 1% или равного качества сервиса для другой модели и сетевого пути.
От региональной квоты к топологии обслуживания
Это развитие не следует смешивать с задачей получить больше инференса в рамках фиксированного энергетического бюджета. Здесь устраняется другое ограничение: географически разрозненная доступность ускорителей. Предлагаемый ответ — объединить их за общей конечной точкой и маршрутизировать запросы на основе сигналов уровня обслуживания модели.
Для планирования мощностей это существенный сдвиг. Командам закупок и инфраструктуры нередко приходилось ждать, пока один регион предоставит достаточно ускорителей для работы сервиса. Результаты Google предлагают иной путь: принимать мощности там, где они доступны, собирать региональный парк и измерениями проверять, обеспечивает ли маршрутизация с учётом состояния требуемый пользовательский опыт и соблюдение операционных границ.
Вывод должен быть сдержанным, а не категоричным. Кросс-региональный инференс не становится автоматически заменой локальной мощности. Но для команд с распределёнными квотами он теперь является серьёзным архитектурным вариантом — и оценивать его нужно как способ организации обслуживания, а не отвергать как аварийный механизм перелива.
Источник: Google Cloud, «GPU and TPU utilization with multi-cluster GKE Inference Gateway», опубликовано 21 сентября 2026 года; документация Google Cloud об эластичной кросс-региональной высокой доступности и multi-cluster inference gateway.

