
Проектирование оценки
Хватит случайно тестировать RAG: сначала составьте карту сложного корпуса
KDDI сообщает о сокращении трудозатрат на оценку RAG на 75% благодаря выборке из сетки форматов файлов и медиасостава. Переносимый урок: распределять тестовые усилия по тем участкам входного пространства, которые действительно меняют поведение системы.
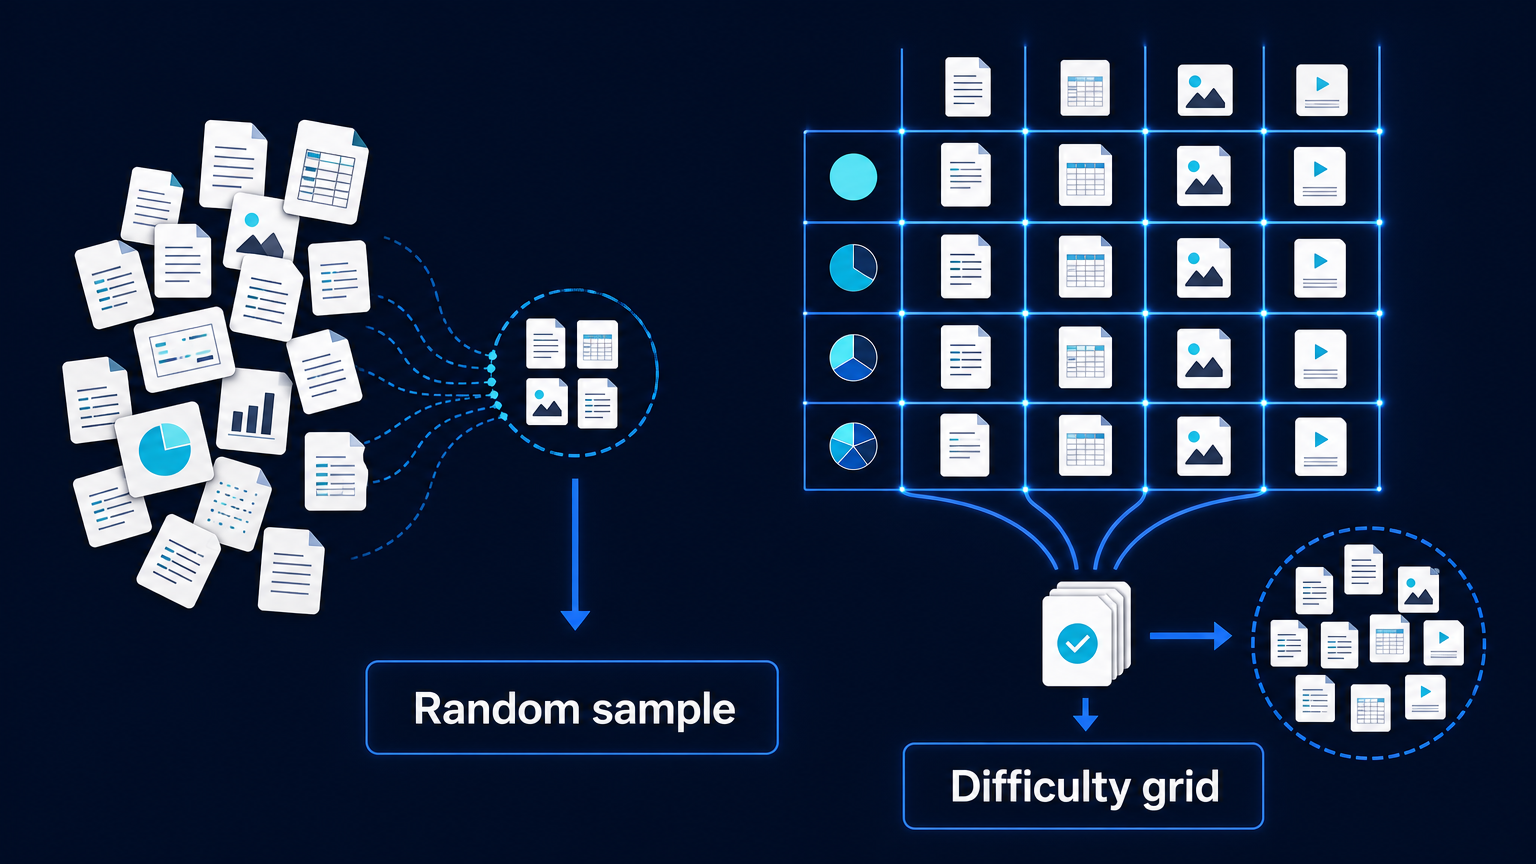
Случайная выборка нередко подменяет собой стратегию оценки. Для RAG-систем с неоднородным корпусом это плохая замена. Чистая веб-статья, PDF с преобладанием изображений, EPUB и структурированная запись могут давать сбои по разным причинам ещё до того, как модель сформулирует ответ. Если эти различия влияют на извлечение, чанкинг, поиск или обоснованность ответа, единая случайная выборка расходует тестовую мощность, не обеспечивая осмысленного покрытия важных условий.
Практичную альтернативу показывает опубликованный 8 сентября кейс KDDI и Google Cloud. При подготовке Buffmee — потребительского RAG-приложения, опирающегося более чем на 100 источников, включая книги, журналы и веб-медиа, — KDDI разложила примеры для оценки по двум осям. Первая — формат файла: веб-статьи, EPUB, PDF и структурированные данные. Вторая — состав медиа: преимущественно текст, преимущественно изображения или смешанный материал. Затем команда выбрала представительные примеры из каждой получившейся ячейки.
KDDI сообщает, что такой подход сократил трудозатраты на оценку на 75% при сохранении комплексного тестового покрытия. Это опубликованный вендором результат одного внедрения, а не универсальный норматив: в статье не раскрыты размеры выборок и нет независимой проверки заявления о покрытии. Но сам принцип важнее процента. Командам RAG следует распределять ограниченную мощность оценки по явно описанной карте входного пространства, а не тратить её равномерно или оставлять выбор тестов случаю.
Корпус — часть поверхности продукта
Оценку RAG часто строят вокруг вопросов и ожидаемых ответов. Это необходимо, но недостаточно. Один и тот же вопрос может привести к разным результатам в зависимости от типа источника, который нужно найти и интерпретировать. Отсканированный документ или PDF с большим количеством изображений выявляет слабости извлечения. Плотные структурированные данные создают для чанкинга и поиска иные трудности, чем обычный текст. В смешанных материалах может возникнуть разрыв между тем, что видит читатель, и тем, как документ представлен в поисковом конвейере.
Поэтому полезной единицей планирования становится не только тестовый запрос и не только документ. Это сочетание характеристик контента, которое может изменить поведение системы. Сетка KDDI делает такие сочетания явными. Она превращает разнородный корпус в страты оценки — определённые группы, из которых можно намеренно выбирать кейсы, а не надеяться, что случайный набор их захватит.
Не нужно механически копировать именно эти оси. Формат файла и медиасостав соответствовали корпусу KDDI. Другому продукту может потребоваться разделять документы по качеству сканов, плотности таблиц, языку, изменчивости версий, ограничениям доступа, авторитетности источника или частоте поиска. Критерий прост: выбирайте характеристики, которые правдоподобно меняют извлечение, поиск, интерпретацию или обоснованность ответа. Категория, не способная изменить поведение, — это административный атрибут, а не страта для оценки.
Сетка должна работать в выпускном процессе
Сетка сложности полезна, только если меняет порядок выпуска. Начните с инвентаризации корпуса и отнесите каждый источник — либо практичную единицу контента внутри него — к выбранным осям. Перечислите все занятые ячейки. Для пустых не нужно выдумывать тесты: они фиксируют сочетания, которые продукт пока не обслуживает. Для занятых нужны именованные представительные кейсы и ответственный за их актуальность по мере изменения корпуса.
- Выберите оси по наблюдаемым свойствам контента, способным изменить извлечение, поиск, интерпретацию или обоснованность ответа.
- Поддерживайте представительные тестовые кейсы для каждой занятой ячейки, включая случаи прежних сбоев и пользовательских жалоб.
- Отметьте критические требования, для которых нужен однозначный результат «пройдено» или «не пройдено», а не усреднённый показатель качества.
- Пересматривайте сетку при появлении новых типов источников, путей загрузки или паттернов контента.
Это не утверждение, что небольшой набор тестов доказывает полное покрытие. Сама по себе никакая выборка этого не доказывает. Это способ сделать аргумент о покрытии проверяемым. Владелец продукта может спросить: какие части корпуса представлены, какие нет и почему. Такая позиция существенно лучше единой оценки, полученной на выборке, состав которой никто не способен объяснить.
Автоматизируйте проверки с чёткой границей
KDDI создала сотни автоматизированных тестов и для отдельных критических метрик использовала бинарную оценку «пройдено/не пройдено». Это важное различие. У критических требований часто есть жёсткая операционная граница: ответ ссылается на подходящий источник или нет; обязательный компонент ответа присутствует или отсутствует; запрос завершается в заданном условии либо не укладывается в него. Для таких требований подходят явные рубрики, аналогичные модульным тестам в разработке ПО.
Не каждое измерение качества устроено так. Полезность, тон и достаточность объяснения могут требовать суждения. KDDI сохранила человеческую оценку владельцев продукта для калибровки порогов автоматического скоринга. Это разумное разделение труда: автоматизация делает повторяемые проверки дешёвыми и единообразными, а выборочная человеческая проверка показывает, соответствует ли автоматическая метрика качеству продукта. Порог не становится валидным лишь потому, что он задан; его подтверждает сопоставление с кейсами, которые он классифицирует.
Кейс сообщает об улучшении показателей groundedness на 25%. Базовый уровень и способ расчёта — абсолютный или относительный — не раскрыты, поэтому это нельзя называть ростом на 25 процентных пунктов. Улучшение groundedness также не доказывает отсутствие галлюцинаций. Практическая ценность уже: команда создала повторяемую практику оценки, способную обнаруживать и направлять работу над качеством во всех заявленных стратах корпуса.
Не смешивайте дизайн оценки и работу над задержкой
Результаты KDDI по производительности относятся к отдельному, вспомогательному направлению. Анализ производственных логов выявил вклад разделения навыков, маршрутизации между субагентами и разрастания промпта в задержку до первого токена. Команда разделила системный промпт объёмом более 800 строк на функциональные ADK Skills и загружала только логику, нужную для конкретного запроса. После этой работы KDDI сообщает о снижении общей задержки приложения на 38% и улучшении времени до первого токена почти на 18%.
Эти результаты не следует приписывать сетке сложности. Сетка концентрирует оценку качества; анализ продакшена и изменения промптов или маршрутизации воздействуют на стоимость и задержку исполнения. Но операционно они усиливают друг друга. Когда у команды есть представительные кейсы по сложным условиям контента, она может проверить, сохранила ли оптимизация задержки поведение именно там, где продукт вероятнее всего сломается. Более быстрый путь, проверенный только на простом тексте, ещё не является производственным результатом.
Управленческий вопрос — куда направить тестовые усилия
Главный урок KDDI не в том, что каждому RAG-продукту нужна матрица два на два, и не в том, что в других случаях следует ждать сокращения работы на 75%. Он в другом: разнородный контент формирует неравномерный ландшафт рисков. Проверять каждый документ обычно нереалистично. Случайная проверка документов считает этот ландшафт плоским. Сетка сложности показывает, где меняется рельеф, и заставляет тестовый набор следовать за ним.
Не спрашивайте, оценивали ли RAG-систему. Спрашивайте, какие условия контента её оценка действительно способна увидеть.
Для руководителей продукта это переводит разговор от объёма тестов к распределению усилий. Прежде чем добавлять автоматические кейсы, определите свойства корпуса, сильнее всего меняющие поведение. Сделайте видимым каждое занятое сочетание. Включите устойчивые представительные кейсы в набор для выпуска. Используйте бинарные проверки там, где у сбоя есть ясная граница, и сохраняйте участие людей там, где метрика требует калибровки. Результатом будет не уверенность в безошибочности, а осознанное и поддерживаемое утверждение: с чем продукт проверенно умеет работать — и с чем пока нет.

