
Надёжность распределённых систем
Повторные попытки могут подпитывать сбой
В глубоком графе сервисов каждая повторная попытка претендует на дефицитную способность системы к восстановлению. Нужна одна назначенная точка восстановления, а не новый цикл повторов на каждом переходе.
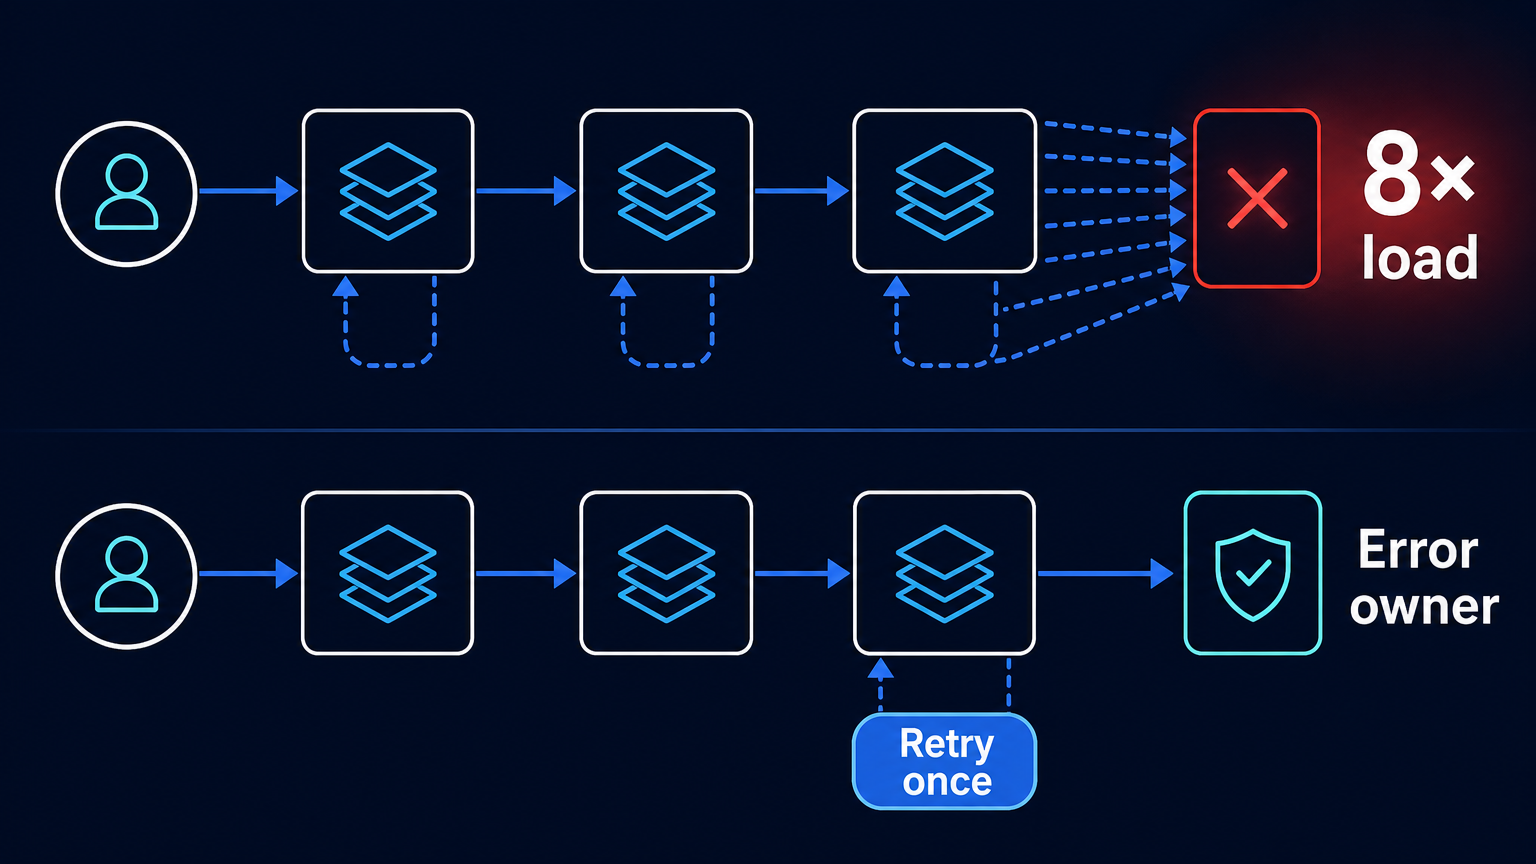
Если смотреть на повторную попытку из одного сервиса, она кажется безобидной. Возник тайм-аут, клиент немного ждёт и отправляет запрос снова. Но в графе зависимостей это локальное решение претендует на общую ёмкость системы: к компоненту, который уже может отказывать или быть перегружен, направляется дополнительная работа. Когда каждый слой независимо принимает одно и то же, на первый взгляд разумное решение, система создаёт именно тот всплеск трафика, который мешает ей восстановиться.
Практическое правило простое: повторную попытку следует расходовать один раз — на уровне, ближайшем к сбою и имеющем основания считать его кратковременным и локально устранимым. Retry — не просто параметр устойчивости у каждого клиента. Это действие по восстановлению, у которого должен быть владелец.
Один пользовательский запрос может разрастись в дерево
Представим запрос, который проходит три уровня зависимостей, прежде чем достигает отказывающего сервиса. Если каждый вызывающий сервис повторяет его один раз, пример Uber показывает: отказывающий сервис может получить восьмикратный объём базового трафика. Математика здесь проста: каждая попытка заново создаёт работу ниже по цепочке, а каждый заново созданный вызов даёт нижним уровням новую возможность повторить запрос. Небольшая локальная политика превращается в мультипликативное поведение всей цепочки вызовов.
Бюджет повторов в 10% на каждом уровне ограничивает скорость такого роста, но не устраняет главную неоднозначность. Какой именно уровень вправе использовать дефицитную дополнительную попытку? Бюджеты отдельных сервисов, экспоненциальная задержка и джиттер ослабляют усиление нагрузки. Но они не отвечают, видит ли верхний сервис новый устранимый сбой или лишь передаёт ту же ошибку, которую нижний вызывающий сервис уже пытался устранить.
Руководство Google по SRE приходит к тому же выводу: в глубоком стеке неудавшийся запрос должен повторять только слой, непосредственно расположенный над отвергнувшим его слоем. Повторы на нескольких уровнях создают комбинаторное усиление. Это архитектурное утверждение, а не рекомендация по настройке параметров.
Сложнее всего установить владельца ошибки
Сервис, вернувший ошибку, не обязательно является сервисом, который её вызвал. Он мог завершиться ошибкой потому, что не удался один из его исходящих вызовов; тогда его ошибка — переданный симптом. Если считать каждую возвращённую ошибку локально принадлежащей сервису, каждый верхний уровень получает право начать ещё один цикл восстановления.
В опубликованном 17 сентября отчёте Uber описан механизм владения ошибкой, работающий в service mesh для пользовательских API. Он сопоставляет входящую ошибку сервиса с ошибками исходящих вызовов, выполненных при обработке данного запроса. Если сервис определяет, что передаёт ошибку, пришедшую снизу, он может вернуть её как не принадлежащую ему. Верхние уровни тогда не повторяют её снова.
Uber сообщает, что во время сбоя 18 ноября 2025 года этот механизм предотвратил, по оценке компании, 9,5 млн лишних запросов. Также компания сообщает о сокращении максимального радиуса retry-штормов в пользовательских API с 25 уровней зависимостей до 3, а среднего — с 20 до 2. Эти цифры относятся к одной производственной среде и не являются прогнозом для других систем. Их более важный смысл в другом: владение повторными попытками можно реализовать и эксплуатировать в крупном service mesh.
Сделайте происхождение повторов частью контракта запроса
Система не сможет обеспечить единственную точку восстановления, если сведения о предыдущих попытках исчезают на каждом переходе. Практический ответ — контракт происхождения повторов в общей RPC- или mesh-инфраструктуре, а не неформальная договорённость в прикладном коде.
Каждый запрос и возвращаемая ошибка должны нести достаточно контекста, чтобы отличить исходную операцию от истории её восстановления: идентификатор исходного запроса, суммарное число попыток, оставшийся дедлайн, классификацию ошибки, признак допустимости повтора и состояние владения, различающее причинную ошибку и переданный симптом. Формат на уровне протокола может быть разным. Операционное требование неизменно: верхний вызывающий сервис должен видеть, что возможность повторить запрос уже была рассмотрена ниже.
- Решение о восстановлении обычно принимает непосредственный вызывающий сервис границы, которой принадлежит ошибка.
- Сервисы, передающие ошибку снизу, возвращают её состояние владения, а не считают её новой локальной неисправностью.
- Верхние сервисы передают результат дальше, не запуская новый цикл повторов.
- При отсутствии, противоречивости или потере сведений о происхождении используется намеренно ограниченный запасной путь, а не молчаливое возвращение к неограниченным повторам.
Это не означает, что все сбои всегда можно идеально атрибутировать. Uber прямо рассматривает совпадающие ошибки и потерю контекста. Поэтому система должна показывать неопределённость и заранее определять поведение при невозможности атрибуции. Опасный вариант по умолчанию — не осторожность, а разрешение каждому уровню выводить новое независимое право на повтор из неполного контекста.
Остальные механизмы по-прежнему необходимы
Владение повтором не заменяет привычные механизмы надёжности. gRPC предоставляет политики повторов для методов, экспоненциальную задержку с джиттером, ограничение повторов, server pushback и телеметрию попыток. Бюджеты повторов Envoy могут ограничивать их объём относительно активных и ожидающих запросов. Google рекомендует лимиты попыток на запрос, бюджеты на клиента и метаданные с числом предыдущих попыток. Всё это полезные механизмы вокруг выбранной точки восстановления.
Владение также не делает безопасными повторы операций с внешними последствиями. Руководство AWS однозначно: автоматические повторы требуют идемпотентных API-контрактов, если повтор операции способен создать дублирующий эффект. Ключ идемпотентности отвечает на вопрос, безопасно ли повторить эффект. Владение повтором отвечает на вопрос, какой слой имеет право сделать попытку. Дедлайн ограничивает время, в течение которого операция может потреблять ресурсы. Это разные задачи.
Измеряйте операцию, а не конфигурацию
Основателям и платформенным командам стоит перестать считать эту проблему чек-листом разумных клиентских настроек. Сервис может иметь скромный бюджет повторов, джиттер и короткий лимит попыток — и всё равно участвовать в разрушительном дереве повторов, если каждая зависимость независимо применяет ту же политику.
Проверяйте сбой зависимости, трассируя одну пользовательскую операцию. Посчитайте общее число попыток по всему графу, определите компонент, который их получает, и зафиксируйте, где была авторизована каждая попытка. Затем намеренно нарушьте происхождение: удалите сигнал владения, потеряйте метаданные о попытках или внесите совпадающую локальную ошибку. Ожидаемым результатом должен быть ограниченный запасной режим, а не возврат к нескоординированным повторам.
Цель не в том, чтобы устранить повторы. Уместно расположенная повторная попытка может сохранить доступность при кратковременном сбое. Цель — добиться, чтобы сбой порождал одно информированное решение о восстановлении, а не набор независимых догадок. В глубокой системе способность к восстановлению общая. Повторную попытку следует рассматривать именно так.

