
Изоляция производительности
Реплика — ещё не граница изоляции
Отдельные вычисления не делают нестабильную нагрузку безвредной. Изоляция заканчивается там, где её путь впервые пересекается с ресурсами production.
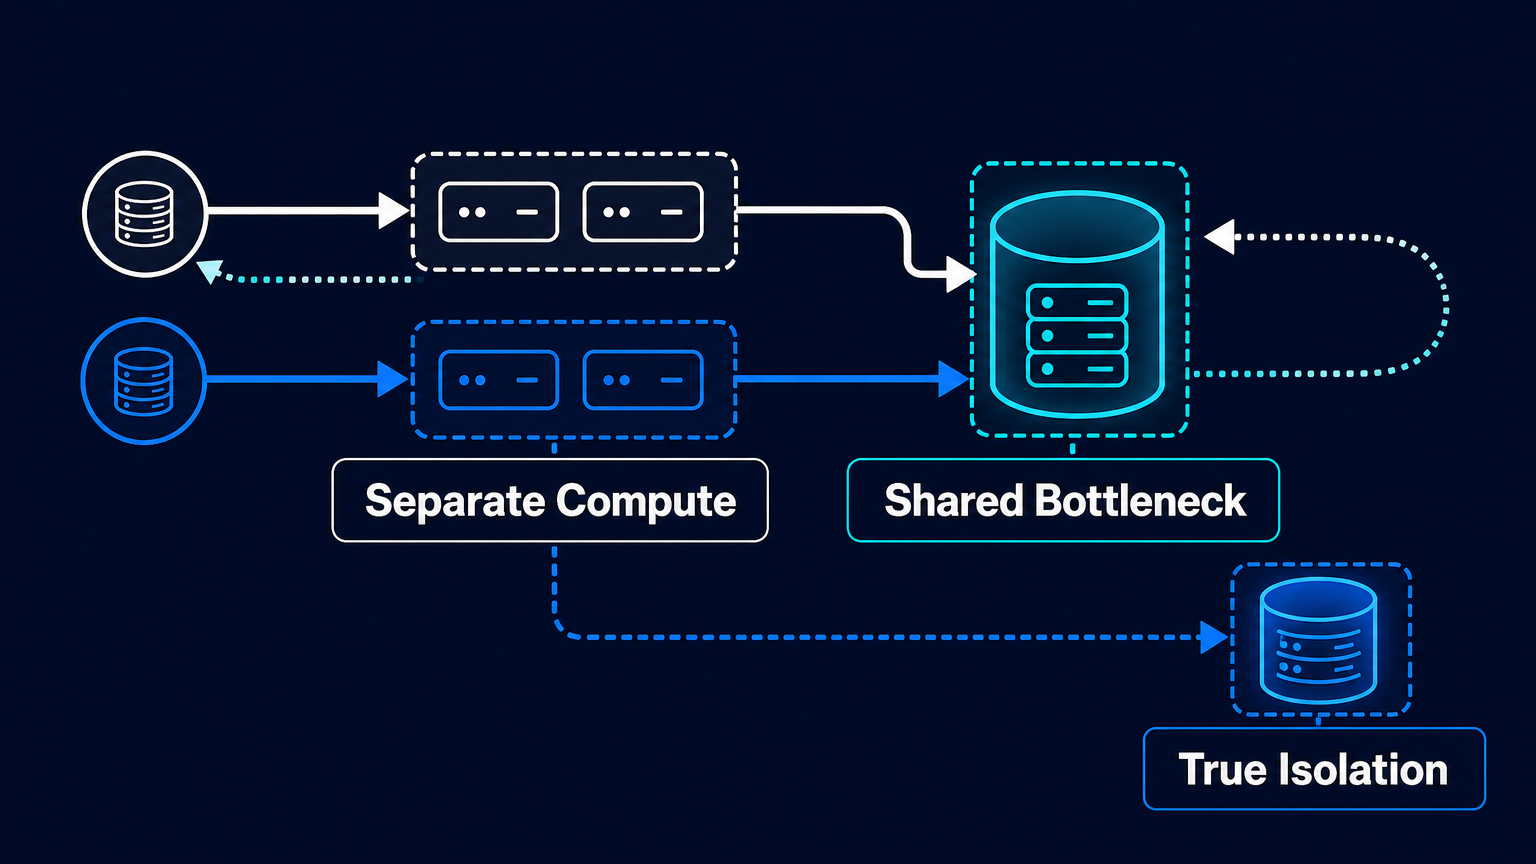
Новый endpoint может быть полезен. Read replica может быть полезна. Отдельная VM, namespace Kubernetes или эфемерная база данных тоже могут быть полезны. Но сами по себе они не доказывают, что нагрузка изолирована от production.
Это различие становится важнее по мере роста числа импульсных читателей: агентных исследовательских запросов, аналитики, отчётности, симуляций, инструментов поддержки и нерегулярных внутренних запросов. Такие нагрузки часто считают безопасными, потому что они read-only и исполняются не в основном процессе приложения. Но read-only не означает отсутствия конкуренции за ресурсы. Нагрузка может не брать write lock и всё же потреблять кэш, пропускную способность хранилища, сеть, сервис метаданных или квоту аккаунта, необходимые production для соблюдения SLO.
Правильный архитектурный вопрос звучит не так: «У нас есть реплики?» Он звучит так: «На каком слое production- и исследовательская нагрузки впервые встречаются?»
Изоляция — свойство пути
Об изоляции нагрузок нередко говорят как о свойстве развёртывания. Одна команда показывает отдельный endpoint, другая — отдельный compute-инстанс, третья — namespace или границу tenant. Это реальные формы разделения, но они отвечают лишь на часть вопроса.
У каждого запроса есть путь. Он начинается у клиента и проходит через compute, кэши, сетевые каналы, сервисы хранения, системы метаданных, механизмы admission control и квоты. Production- и исследовательский трафик могут быть раздельны на первых нескольких шагах, а затем сойтись на общем ресурсе. Этот первый общий ресурс и есть содержательная граница изоляции.
Если обе нагрузки зависят от одного перегруженного page server, всплеск чтений всё ещё способен замедлить production. Если они конкурируют за кэш, исследовательские сканы могут вытеснить данные, полезные основной системе. Если они делят сетевое узкое место, квоту или сервис метаданных, отдельные узлы базы не обязательно остановят распространение инцидента. Отдельный compute поглощает спрос на вычисления, но не устраняет автоматически спрос ниже по пути.
Это не означает, что общие компоненты сами по себе небезопасны. Их можно разделять, ограничивать, планировать и защищать admission control. Тезис уже: слово «изолирована» должно означать доказанную невозможность распространения конкуренции, а не просто схему с разными прямоугольниками.
AlloyDB делает различие предметным
Preview PostgreSQL for agents в AlloyDB, объявленный Google 24 сентября, полезен именно потому, что его архитектурное заявление выходит за пределы большого числа временных узлов базы. Google сообщает, что сервис создаёт независимые read-only узлы AlloyDB в microVM, даёт им доступ к состоянию production со свежестью менее секунды и уменьшает их число после завершения работы. Но важнее другое: по словам Google, агентные чтения используют отдельные сегменты Colossus и не проходят через компоненты production-базы. Компания описывает разделение как распространяющееся на compute, сеть и хранилище.
Сервис остаётся preview в рамках условий Google Cloud Pre-GA, может иметь ограниченную поддержку и сейчас требует запроса на доступ. Это не объявление общей доступности. Его показатели производительности также нельзя считать гарантией для всех клиентов: во внутреннем тесте Google масштабировала число агентных узлов с одного до 1 000, получила 3 млн запросов в секунду совокупной пропускной способности и не зафиксировала измеримого ухудшения primary-кластера. Это данные вендора, а не независимо воспроизведённый результат.
Тем не менее главное здесь — архитектурное заявление. Google утверждает не просто наличие отдельного compute для агентного трафика. Она утверждает, что путь к хранилищу не конкурирует с путём production-базы. Достигает ли конкретное развёртывание заявленного эффекта, ещё предстоит проверять нагрузочным тестом. Но это заявление точно указывает на слой, на котором обычной схемы реплик может оказаться недостаточно.
Read offload и изоляция — разные продукты
Обычные реплики по-прежнему ценны. Они могут повышать доступность, распределять предсказуемые чтения и создавать полезное операционное разделение. Но их архитектура может намеренно сохранять общие компоненты хранения. AWS документирует, что reader-инстансы Aurora подключаются к тому же cluster storage volume, что и primary. Microsoft документирует, что HA- и named replicas Azure SQL Hyperscale используют те же page servers, что и primary, тогда как geo-replicas получают отдельный набор.
Ни один из этих фактов не доказывает недостаточную изоляцию в конкретном развёртывании Aurora или Azure SQL. Производительность зависит от разделения ресурсов в продукте, характера нагрузки, квот, admission control и операционной конфигурации. Примеры показывают более базовую вещь: даже разные типы реплик внутри одного семейства продуктов имеют разную топологию общей судьбы. Поэтому ответ «у нас есть реплика» недостаточен для требования к изоляции производительности.
Это различие должно предотвратить и частую ошибку закупки. Покупатель спрашивает, поддерживает ли платформа тысячи читателей, получает обоснованное «да», но не спрашивает, что произойдёт с primary при враждебном всплеске. Масштабирование и изоляция — связанные, но разные утверждения. Система способна масштабировать читателей и сохранять одно или несколько общих узких мест. Она также может изолировать конкретный путь, продолжая использовать более широкую общую физическую инфраструктуру. Обещание всегда ограничено рассматриваемым путём ресурсов и условием нагрузки.
Называйте нагрузку «изолированной» только тогда, когда её конкуренция за ресурсы не может перейти через важную для вас границу.
Запрашивайте карту пути изоляции
Основателям и операторам не нужно вскрывать устройство каждого managed-сервиса. Но для каждого класса нестабильной нагрузки им нужен конкретный артефакт: карта пути изоляции. Она должна прослеживать путь от читателя к состоянию production, к которому тот обращается, и делать общие зависимости явными.
- Опишите размещение compute и лимиты runtime: где исполняются читатель и primary, какие CPU-, memory- или host-ресурсы они могут делить?
- Проследите зависимости кэша и сети: могут ли нагрузки конкурировать за ёмкость кэша, connection pool, сетевые каналы, gateway или лимиты балансировщика?
- Проследите зависимости хранения и управления: какие storage server, page service, системы метаданных, сервисы репликации и пути восстановления у них общие?
- Определите границы квот и admission control: какие tenant-, project-, account- или региональные лимиты потребляют оба класса?
- Отметьте первую общую точку насыщения, её предел ёмкости, защитный механизм и команду-владельца.
После этого протестируйте карту. Удерживайте primary-нагрузку на репрезентативном production-уровне. Затем подайте враждебный всплеск чтений с теми формами запросов, параллелизмом и паттернами сканирования, которые нестабильная нагрузка действительно может создать. Наблюдайте latency, error rate и throughput primary, а также сигналы насыщения конкретных ресурсов. Повторите тест на ожидаемых границах квот и кэша, а не только на endpoint читателя.
Тест не обязан доказывать, что production никогда не пострадает. Он должен установить, что произойдёт при нагрузках, которые организация готова разрешить. Если конкуренция распространяется, архитектура всё ещё может быть приемлемой. Называйте её read offload, изоляцией доступа или разделением compute — и применяйте соответствующие rate limits и планирование ёмкости. Точные слова дают операторам правильную модель эксплуатации.
Обещание определяет узкое место
Рост числа автономных и исследовательских читателей делает эту дисциплину срочной, но правило старше ИИ. Исследования Google о shared compute-кластерах называют кэши процессоров и шины памяти источниками интерференции производительности. Разделение на одном слое никогда не гарантировало разделения на всех слоях ниже.
Production-система изолирована от нестабильной нагрузки лишь настолько, насколько их пути ресурсов независимо защищены. Отдельный endpoint — решение об интерфейсе. Реплика — решение о топологии. Отдельный compute-fleet — решение о ёмкости. Они становятся решением об изоляции только тогда, когда путь до первого существенного узкого места раздельный либо когда для общего узкого места доказан механизм, не позволяющий конкуренции одной нагрузки превратиться в сбой другой.
Именно этот стандарт стоит вносить в архитектурный review. Не спрашивайте, отделён ли читатель. Спросите, куда уходит создаваемое им давление.

