
Эксплуатация инфраструктуры
Lambda нашла место для трёх дополнительных AI-узлов в прежнем лимите мощности
В валидации Lambda на пяти стойках NVIDIA DSX MaxLPS повысила производительность чистого инференса на 24% в фиксированном лимите 129 кВт. Это не универсальный бенчмарк, а операционное подтверждение: динамическое распределение мощности должно стать частью планирования AI-мощностей.
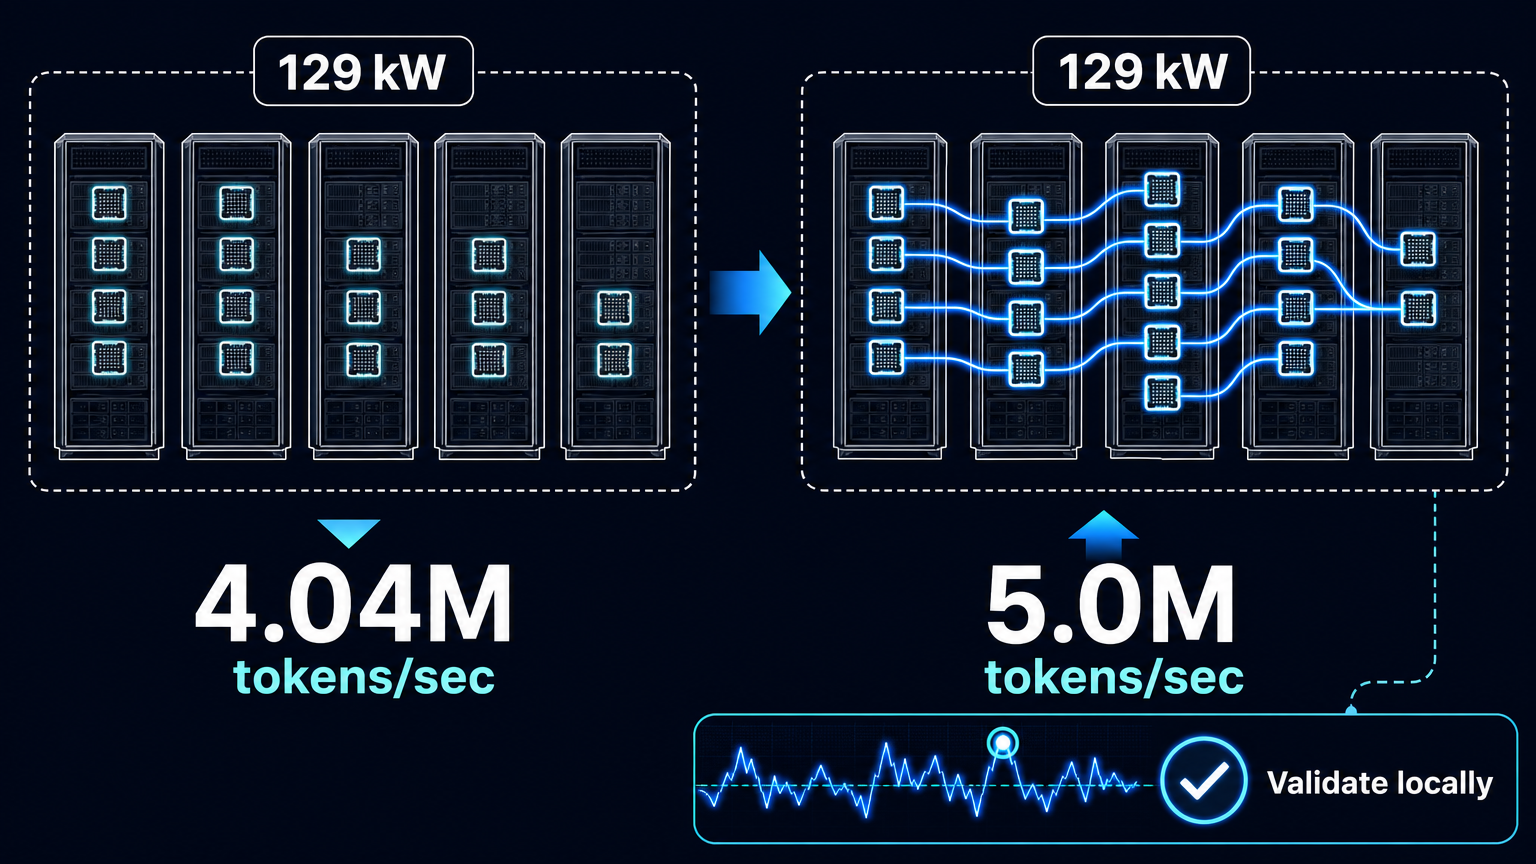
Первый вопрос в AI-ЦОДе, ограниченном по мощности, обычно физический: сколько электроэнергии выдержат здание, стойки и подключение к сети? Последняя валидация Lambda предлагает добавить второй, более полезный вопрос: какая часть этой мощности теряется из-за статических допущений при её распределении?
15 сентября NVIDIA опубликовала результаты первой валидации DSX MaxLPS в среде развертывания Lambda на серверах Blackwell. В кластере из пяти стоек Lambda запустила 19 узлов NVIDIA HGX B200 в лимите мощности, который прежде был выделен для 16 узлов. В тесте чистого инференса производительность кластера выросла примерно с 4,04 до 5 млн токенов в секунду, оставаясь в пределах 129 кВт. Это рост производительности на 24%, а также заявленные улучшение производительности на ватт по всему кластеру на 23% и увеличение активной GPU-ёмкости на 19%.
Изменился не лимит площадки и не поколение серверов. Изменился способ распределения доступной мощности внутри кластера. Не изменилось другое важное обстоятельство: это контролируемый proof of concept на заданных MLPerf-нагрузках инференса и обучения, а не заявление о производительности всего парка в production и не обещание, что каждый оператор получит дополнительные 24% результата.
Статические лимиты защищают площадку — и могут оставлять мощность неиспользованной
У традиционного подхода к резервированию есть понятная логика. Если все узлы способны одновременно выйти на пиковое потребление, площадка должна иметь запас под такой сценарий. Фиксированные лимиты на узел или стойку просты в применении и позволяют контролировать общий контур. Но они предполагают, что разнородная AI-нагрузка ведёт себя как синхронный стресс-тест.
На практике кластеры часто работают иначе. Обучение, инференс, обмен данными и периоды простоя создают меняющийся спрос на GPU и стойки. Если одна нагрузка потребляет меньше выделенного ей лимита, при статической политике её неиспользованный резерв не помогает другому узлу. Кластер остаётся в рамках бюджета, но часть доступного запаса нельзя использовать.
DSX MaxLPS предназначен для мониторинга потребления GPU и стоек и перераспределения такого неиспользованного запаса между узлами. В конфигурации Lambda для чистого инференса кластер с политикой мощности 85% запустил 19 узлов в тех же 129 кВт, что и базовая конфигурация из 16 узлов. Практический результат — не снижение абсолютного потребления, а больше токенов в секунду в прежнем лимите мощности площадки.
Для AI-площадки с ограничением по мощности дефицитным ресурсом могут быть не только установленные GPU или законтрактованные мегаватты. Им может оказаться способность распределять уже доступную мощность в соответствии с фактическим спросом нагрузки.
Результат узкий. Вывод для планирования — широкий.
Lambda также проверила одновременное обучение и инференс. При фиксированном бюджете мощности компания сообщила о росте производительности обучения на 17% и инференса на 20%. Эти показатели подтверждают сам эксплуатационный паттерн: смешанные нагрузки могут создавать перераспределяемый запас. Но они не доказывают универсальный прирост, новую стоимость токена или отсутствие компромиссов.
Динамическое управление мощностью не устраняет конкуренцию, а перераспределяет её. Политика может сохранить приоритетную работу, замедлив, приостановив или перенеся низкоприоритетные задачи. Это может быть приемлемо для пакетного обучения, офлайн-оценки или задач, которые можно отложить. Но это может быть неприемлемо для инференса с жёсткими требованиями к задержке, тесно связанного обучающего прогона или нагрузки с небольшим запасом стабильности. Поэтому важен не только пиковый throughput, а throughput при тех ограничениях по задержке, качеству, надёжности и соблюдению энергобюджета, которые оператор обязан выдержать.
Это прямо отражено в рекомендациях NVIDIA: внедряющим организациям необходимо проверять эффект на собственных нагрузках, требованиях к задержке и ограничениях соблюдения лимитов мощности. Эту оговорку следует считать требованием к внедрению, а не примечанием к бенчмарку.
В планировании мощности появилась программная переменная
Для руководителей инфраструктуры непосредственное следствие — изменение метода. Прежде чем вкладываться в новую площадку, дополнительную электрическую мощность или новое оборудование, стоит проверить, может ли распределение мощности с учётом нагрузки безопасно повысить полезный выпуск в текущем контуре. Это не аргумент против расширения сети или закупок. Многим площадкам по-прежнему понадобятся и то и другое. Это аргумент против того, чтобы считать их единственным способом нарастить мощность.
Начинать следует с ограниченного кластера и явно заданного лимита площадки. Зафиксируйте базовый уровень на текущей конфигурации с фиксированными лимитами. Затем классифицируйте нагрузки по приоритету, допустимой задержке, допустимости прерывания и ожидаемому профилю энергопотребления. Проверяйте динамическую политику на репрезентативном трафике, а не только на синтетическом пике; сравнивайте throughput токенов, хвостовую задержку, ошибки и повторы, завершение задач, использование GPU и соблюдение суммарного лимита мощности.
Нужно заранее решить и зафиксировать, что именно может уступить при превышении спросом доступного контура. Если инференс важнее обучения, это операционное решение следует закодировать в политике и проверить его последствия. Если ни одна нагрузка не может замедляться, значит запас мощности фактически недоступен. Распределение мощности — это политика ёмкости, а не просто параметр настройки.
- Сохраняйте жёсткий общий лимит мощности площадки, а не оптимизируйте узлы по отдельности.
- Измеряйте результаты на уровне нагрузки: throughput, хвостовую задержку, стабильность, качество и время завершения.
- Явно задавайте приоритеты и правила ограничения до того, как событие спроса вынудит импровизировать.
- Считайте результаты пилота локальным операционным свидетельством и повторяйте проверки после изменений моделей, serving-стека, оборудования или состава нагрузок.
Отдельная демонстрация для энергосети подтверждает паттерн, но не этот бенчмарк
NVIDIA также сообщила о демонстрации коммерческого масштаба на площадке Eos: потребление было снижено с четырёх до трёх мегаватт менее чем за минуту при сохранении высокоприоритетных нагрузок. По данным NVIDIA, Silicon Valley Power затем отправила более 200 успешных сигналов управления спросом. Это релевантное свидетельство того, что AI-вычисления могут реагировать на внешний энергетический сигнал через управление нагрузками с учётом их приоритета.
Но эту демонстрацию нельзя смешивать с результатом Lambda. В Санта-Кларе использовался Emerald AI Conductor, а не production-развертывание DSX Flex; NVIDIA прямо описывает эксперимент как более раннее подтверждение паттерна, который DSX Flex должен обобщить. Операционные цифры приведены NVIDIA и не являются результатом независимого аудита. Измеренный прирост Lambda в 24% относится к отдельной валидации DSX MaxLPS на пяти стойках.
Полезное решение — сначала проверить, потом строить
Смысл валидации Lambda не в том, что программное обеспечение отменило потребность в энергетической инфраструктуре, и не в том, что плюс 24% throughput стал отраслевой нормой. Она показывает другое: привычное инфраструктурное ограничение отчасти стало управляемым через планирование. В проверенной конфигурации распределение мощности под контролем ПО высвободило место для трёх дополнительных узлов в прежнем бюджете и превратило это место в измеримый throughput.
Для операторов, упирающихся в лимит мощности, этого достаточно, чтобы изменить порядок решений. Сначала нужно описать нагрузку и её сервисные ограничения. Затем — проверить динамическое распределение в жёстком контуре. И только измерив, какую дополнительную производительность можно безопасно получить, решать, сколько новой электрической мощности, оборудования или площадей действительно необходимо покупать. Физическое ограничение остаётся. Статическое допущение о том, как его использовать, — нет.

